Microsoft SQL Server · Healthcheck & Audit

SQL Server Health Check,
auf Ihre Frage zugeschnitten.

Healthcheck, Performance-Audit, Review oder Bestandsaufnahme: Jeder nennt es anders. Bei uns steckt dasselbe Verfahren dahinter, mit festen Schritten, einem festen Prüfraster und einem Bericht, der jeden Befund belegt.

bericht · Seite 1 · Zusammenfassungillustratives Beispiel
  • Konfiguration & Instanz2 Hinweise
  • Version & PatchstandCU veraltet
  • Sicherheit & Berechtigungenohne Befund
  • Backup, Restore & WiederanlaufRestore nie getestet
  • WartungStatistiken unregelmäßig
  • Workload & Abfragen3 Abfragen, 60 % der CPU
Die drei wichtigsten Maßnahmen
  1. Restore der Hauptdatenbank testen und Zeit messen
  2. Statistikwartung an die Ladezeiten anpassen
  3. Die drei teuersten Abfragen gezielt untersuchen
Ein Verfahren, viele Zuschnitte

Was immer gleich ist, und was wir zuschneiden.

Kein Healthcheck gleicht dem anderen, und trotzdem erfinden wir ihn nicht jedes Mal neu. Ablauf, Prüfraster und Bericht stehen fest. Worauf wir schauen und wie tief, legen wir mit Ihnen im Kick-off fest.

Immer gleich
  • Ablauf in festen SchrittenVom Kick-off bis zur Ergebnisbesprechung.
  • Prüfraster mit festen BereichenVon der Konfiguration bis zur einzelnen Abfrage.
  • BefundformatJeder Befund mit Beobachtung, Beleg, Risiko, Empfehlung und Aufwand.
  • Bericht und BesprechungGleicher Aufbau, damit Sie Berichte über Jahre vergleichen können.
Zugeschnitten
  • SchwerpunktBetrieb, Performance, Verfügbarkeit, Migration, Upgrade oder Data Warehouse.
  • Tiefe je BereichVertieft, im Überblick oder bewusst ausgelassen.
  • UmfangEine Instanz, eine Anwendung oder eine ganze Umgebung.
  • ErhebungszeitraumMomentaufnahme oder ein Zeitraum mit Ihren typischen Lastspitzen.

Der Kick-off endet mit einem schriftlichen Untersuchungsauftrag: Ziel, Zuschnitt, Umfang, Erhebung, Termine und Aufwand. So wissen beide Seiten vorher, was am Ende auf dem Tisch liegt.

Ablauf

Sechs Schritte, jedes Mal.

  1. 01

    Kick-off

    Etwa eine Stunde: Anlass, Ziele und Zuschnitt klären, Ansprechpartner benennen. Ergebnis ist der Untersuchungsauftrag.

  2. 02

    Erhebung

    Konfiguration und Kennzahlen erfassen. Bei Performance-Fragen über einen Zeitraum, der Ihre typischen Lastspitzen enthält.

  3. 03

    Auswertung

    Jeden Bereich des Prüfrasters durchgehen, Befunde belegen und im Zusammenhang einordnen.

  4. 04

    Bericht

    Fester Aufbau: Zusammenfassung, Befundliste, Maßnahmenplan, Anhang mit Messdaten.

  5. 05

    Ergebnisbesprechung

    Mit Ihrem Technikteam und auf Wunsch mit den Verantwortlichen, jeweils in deren Sprache.

  6. 06

    Nachmessung optional

    Nach umgesetzten Maßnahmen messen wir erneut. Der Bericht dient dabei als Ausgangswert.

untersuchungsauftrag.txtillustratives Beispiel
ziel       Klären, ob die Umgebung nach dem Hardwaretausch so läuft wie geplant.
zuschnitt  Nach Migration / Hardwaretausch, Schwerpunkt Workload und Wartung.
umfang     2 Instanzen, 14 Datenbanken, eine Kernanwendung.
erhebung   Skripte führt Ihr Team aus; 10 Werktage inkl. Monatsabschluss.
termine    Bericht und Besprechung in KW 44.
aufwand    Schriftlich vereinbart, bevor die Erhebung beginnt.
Worauf wir schauen

Neun Bereiche, vom Fundament bis zur Abfrage.

Das Prüfraster ist in jedem Healthcheck dasselbe. Je nach Zuschnitt gehen wir einem Bereich auf den Grund oder verschaffen uns einen Überblick.

01

Konfiguration & Instanz

  • Passen Speicher, Parallelität und tempdb zur Last?
  • Welche Einstellungen weichen ohne Grund vom Standard ab?
02

Version, Patchstand & Supportende

  • Welche Updates fehlen, welche sind bekannt problematisch?
  • Wann endet der Support Ihrer Version?
Ihren Build vorab selbst prüfen →
03

Sicherheit & Berechtigungen

  • Wer hat mehr Rechte, als er braucht?
  • Wie sind Anmeldungen, Verschlüsselung und Überwachung geregelt?
04

Backup, Restore & Wiederanlauf

  • Lässt sich aus den Sicherungen wirklich wiederherstellen?
  • Wie lange dauert es, und wie viele Daten fehlen danach?
05

Hochverfügbarkeit & DR

  • Funktioniert der Failover so, wie er dokumentiert ist?
  • Passen RPO und RTO zu Ihren Zielen?
06

Wartung

  • Laufen Index-, Statistik- und Integritätsprüfungen, und zur richtigen Zeit?
  • Passen die Jobs noch in ihr Zeitfenster?
07

Ressourcen & Kapazität

  • Wo liegt der Engpass: CPU, Speicher, I/O oder Netzwerk?
  • Wie lange reicht die Plattform bei heutigem Wachstum?
08

Workload & Abfragen

  • Welche Abfragen verursachen die meiste Last?
  • Wo verlieren Pläne, Wartezeiten und Blockierungen Zeit?
09

Edition & Cores

  • Nutzen Sie, wofür Sie bezahlen?
  • Welche Edition und Core-Zahl braucht die Last wirklich?
Ihr Schwerpunkt

Sechs Zuschnitte, ein Raster.

Die häufigsten Anlässe haben bei uns einen Namen. Jeder Zuschnitt nutzt dasselbe Prüfraster, setzt aber andere Schwerpunkte. Wählen Sie einen Zuschnitt, um zu sehen, worauf er sich konzentriert.

Standortbestimmung

Basis-Healthcheck

„Ist unser SQL Server solide aufgestellt, und wo liegen die größten Risiken?“

Typischer Anlass
Ein System wurde übernommen, ist lange nicht geprüft worden, oder die Verantwortung wechselt. Oft auch vor einem Betriebsvertrag oder einem Audit.
Erhebung
Momentaufnahme von Konfiguration, Sicherung, Wartung und Berechtigungen, ergänzt um die Kennzahlen seit dem letzten Neustart.
Im Bericht zuerst
Was Sie Daten oder Verfügbarkeit kosten kann, danach alles, was den Betrieb unnötig erschwert.
Wenn es langsam ist

Performance-Audit

„Wo verliert unsere Anwendung Zeit, und welche Änderung bringt am meisten?“

Typischer Anlass
Antwortzeiten schwanken, die Last steigt ohne klaren Grund, nächtliche Jobs passen nicht mehr in ihr Zeitfenster.
Erhebung
Die Ausführungshistorie im Query Store Ihrer Datenbanken, ausgewertet mit PSG QX. Sie sollte Ihre typischen Lastspitzen enthalten, etwa einen Monatsabschluss.
Im Bericht zuerst
Die teuersten Abfragen und ihre Pläne, Wartezeiten und Engpässe. Maßnahmen sortiert nach erwarteter Wirkung.
Mehr zur Performance-Analyse →
Wenn es ausfallen darf, aber nicht lange

Verfügbarkeits-Review

„Hält unser Wiederanlauf, was wir versprechen?“

Typischer Anlass
Neue Vorgaben zu Datenverlust und Ausfallzeit, ein Audit oder ein Ausfall, der gerade noch gut ging.
Erhebung
Availability Groups oder Cluster, Sicherungsketten und Restore-Zeiten. Auf Wunsch begleiten wir einen Restore- oder Failover-Test.
Im Bericht zuerst
Ihre Ziele für RPO und RTO neben den Werten, die heute tatsächlich erreichbar sind.
Mehr zu Hochverfügbarkeit →
Nach dem Umzug

Nach Migration oder Hardwaretausch

„Läuft die neue Umgebung so, wie sie geplant war?“

Typischer Anlass
Neue SQL-Server-Version, neue Hardware, Umzug in virtuelle Maschinen oder ein anderes Rechenzentrum.
Erhebung
Konfiguration und Kennzahlen der neuen Umgebung, wenn vorhanden im Vergleich mit Messwerten der alten. Kompatibilitätsgrad und Planänderungen stehen dabei besonders im Blick.
Im Bericht zuerst
Einstellungen, die beim Umzug liegen geblieben sind, und Abfragen, die seitdem schlechter laufen.
Vor der nächsten Version

Upgrade- & Lizenz-Check

„Welche Version, Edition und Core-Ausstattung brauchen wir wirklich?“

Typischer Anlass
Eine Version läuft aus dem Support, ein Upgrade oder eine Konsolidierung steht an, oder die Lizenzkosten sollen auf den Prüfstand.
Erhebung
Versionen, Editionen und genutzte Funktionen, Core-Zahl und tatsächliche Auslastung über einen repräsentativen Zeitraum.
Im Bericht zuerst
Ein Upgrade-Pfad mit seinen Risiken, dazu Edition und Cores aus Ihrer Sicht. Wir verkaufen keine Lizenzen.
Unsere Haltung zu Edition & Cores →
Für Data Warehouses

DWH-Audit

„Trägt unser Data Warehouse die nächsten Jahre?“

Typischer Anlass
Ladeprozesse werden länger, Berichte langsamer, und das Data Warehouse ist über die Jahre gewachsen.
Erhebung
Ladeprozesse, Datenmodell, Partitionierung, Columnstore-Indizes und Berichtsabfragen über mindestens einen vollständigen Ladezyklus.
Im Bericht zuerst
Ladefenster, Speicherbedarf und Abfragewege, und wo Columnstore, Partitionierung oder ein anderes Ladeverfahren hilft.
Welcher Zuschnitt welchen Prüfbereich wie tief betrachtet (illustrativ)
Prüfbereich
Konfiguration & Instanz
Version & Patchstand
Sicherheit & Berechtigungen
Backup & Wiederanlauf
Hochverfügbarkeit & DR
Wartung
Ressourcen & Kapazität
Workload & Abfragen
Edition & Cores

vertieftim Überblicknicht enthalten

Ihr Anlass ist nicht dabei? Dann schneiden wir den Healthcheck im Kick-off passend zu. Das Raster bleibt dasselbe.

Für Softwarehersteller: das Product Performance Review →
Was Sie bekommen

Ein Bericht, der sich nachprüfen lässt.

Jeder Befund steht für sich: was wir beobachtet haben, woran man es sieht, was es riskiert und was wir empfehlen. So lässt sich jede Empfehlung prüfen, priorisieren und einzeln umsetzen.

  • Eine Seite Zusammenfassung
    Ampel je Prüfbereich und die drei wichtigsten Maßnahmen, auch für die Geschäftsführung lesbar.
  • Befundliste
    Bereich, Beobachtung, Beleg, Risiko, Empfehlung, Aufwand und Priorität.
  • Maßnahmenplan
    Sofort, in den nächsten Wochen, strategisch.
  • Anhang
    Messdaten und Methode, damit das Ergebnis nachvollziehbar bleibt.
befund-07.txtillustratives Beispiel
bereich      Backup, Restore & Wiederanlauf
beobachtung  Vollsicherung täglich, Protokollsicherung stündlich. Ein Restore wurde nie getestet.
beleg        Sicherungshistorie der letzten 90 Tage; keine Restore-Einträge.
risiko       Bis zu 60 Minuten Datenverlust; Dauer des Wiederanlaufs unbekannt.
empfehlung   Protokollsicherung alle 15 Minuten; Restore-Test mit Zeitmessung, dann vierteljährlich.
aufwand      gering
priorität    sofort
Warum nicht einfach ein Prüfskript?

Die Liste gibt es frei. Die Einordnung nicht.

Gute Prüfskripte gibt es seit Jahren kostenlos.

Was eine Liste nicht leistet: zu entscheiden, welcher von vierzig Hinweisen in Ihrer Umgebung wirklich zählt.

  • Einordnung
    Was ist bei Ihrer Anwendung und Ihrem Betrieb ein Risiko, und was nur eine Abweichung vom Lehrbuch?
  • Priorisierung
    Welche drei Maßnahmen bringen am meisten, und in welcher Reihenfolge?
  • Belege über Zeit
    Ein Skript sieht einen Moment. Wir messen über Ihre Lastspitzen hinweg.
  • Wirkung prüfen
    Nach der Umsetzung messen wir nach, ob die Maßnahme gewirkt hat.
Danach

Der Bericht ist ein Anfang, kein Abschluss.

Viele Maßnahmen setzt Ihr eigenes Team um. Den Bericht schreiben wir so, dass das geht. Wo Sie Unterstützung möchten, gibt es drei Wege, und für intensive Healthchecks unser Analysewerkzeug.

Nach der Umsetzung

Nachmessung

Wir messen erneut und vergleichen mit dem Bericht. So sehen Sie, was die Maßnahmen tatsächlich bewirkt haben.

Im Rhythmus

Wiederholung

Jährlich oder nach größeren Änderungen, mit demselben Raster. So werden die Berichte über die Jahre vergleichbar.

Laufend

DBA Pool & PSG MX

Betrieb gemeinsam mit Ihrem Team oder kontinuierliches Performance Engineering für kritische Anwendungen.

Laufende Begleitung →
Optional · für intensive Healthchecks

Mit PSG QX tiefer und länger hinsehen.

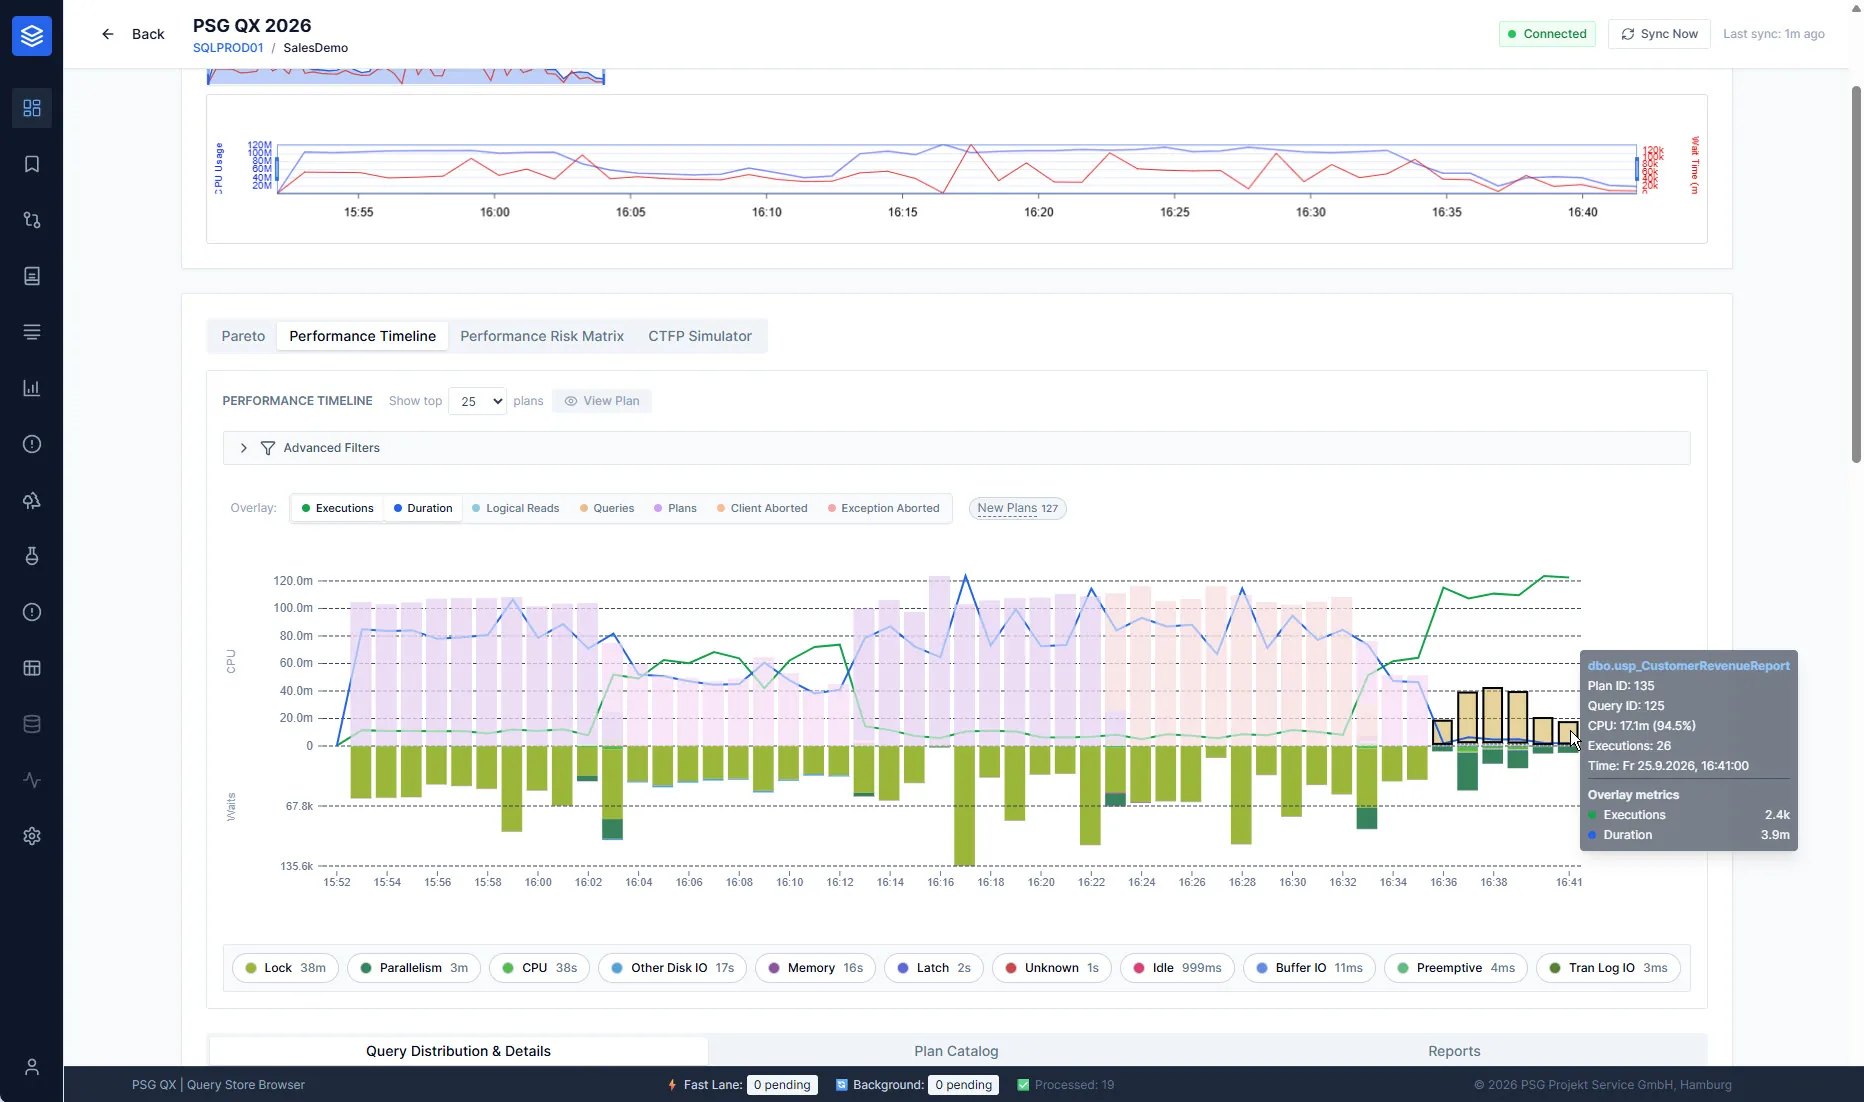
Bei einem intensiven Healthcheck werten wir auf Wunsch mit PSG QX den Query Store Ihrer Datenbanken aus. Er enthält die Ausführungshistorie der vergangenen Wochen: welche Abfrage, welcher Plan, seit wann und mit welchen Wartezeiten. Ist der Query Store noch nicht aktiv, schalten wir ihn zu Beginn ein und lassen ihn sich füllen. QX muss dafür nicht dauerhaft laufen.

  • Rückblick statt Momentaufnahme
    Die Historie zeigt auch Lastspitzen und Probleme, die heute gerade nicht auftreten.
  • Bis zur Codezeile
    Befunde zeigen auf die Abfrage und die Stelle, die Last verursacht.
  • Nachmessung mit demselben Blick
    Nach umgesetzten Maßnahmen zeigt dieselbe Auswertung vorher und nachher.
Mehr zu PSG QX →
PSG QX · Performance-Timeline
PSG QX: Performance-Timeline mit CPU, Wartezeiten und Plänen
Häufige Fragen

Kurz beantwortet.

Wie lange dauert ein SQL Server Health Check?

Das hängt vom Zuschnitt ab. Der Kick-off dauert etwa eine Stunde. Eine Momentaufnahme ist schnell erhoben; bei Performance-Fragen messen wir über einen Zeitraum mit Ihren typischen Lastspitzen, oft ein bis zwei Wochen. Den Zeitplan halten wir im Untersuchungsauftrag fest.

Brauchen Sie Zugriff auf unsere Server?

Nicht unbedingt. Die Erhebung kann über Skripte laufen, die Ihr Team ausführt, oder gemeinsam in einer Teams- oder Zoom-Sitzung mit geteiltem Bildschirm. Ob und wie wir direkt zugreifen, regelt der Auftrag.

Welche Daten verlassen unsere Umgebung?

Wir erheben Konfiguration, Kennzahlen und Abfragestatistiken, keine Inhalte Ihrer Tabellen. Welche Daten genau übergeben werden, sehen Sie vorher und legen es im Untersuchungsauftrag fest.

Was müssen wir vorbereiten?

Einen Ansprechpartner aus Betrieb oder Entwicklung, die Antworten aus dem Kick-off und, falls vorhanden, bekannte Auffälligkeiten und frühere Berichte. Den Rest bringen wir mit.

Was kostet ein Healthcheck?

Der Aufwand hängt von Zuschnitt und Umfang ab. Wir legen ihn nach dem Kick-off schriftlich fest, bevor die Erhebung beginnt.

Ist ein Healthcheck dasselbe wie eine Performance-Analyse?

Der Performance-Audit ist einer der Zuschnitte. Ein Basis-Healthcheck schaut breiter, auch auf Sicherung, Sicherheit und Wartung. Brennt es gerade, ist ein Healthcheck der falsche Weg: Dann hilft unser Performance Troubleshooting.

Können wir den Bericht selbst umsetzen?

Ja. Jede Empfehlung ist begründet und mit Aufwand und Priorität versehen, damit Ihr Team sie umsetzen kann. Auf Wunsch unterstützen wir einzelne Maßnahmen oder messen danach nach.

Kontakt

Welche Frage soll Ihr Healthcheck beantworten?

Im ersten Gespräch klären wir Anlass und Ziel und schlagen einen passenden Zuschnitt vor.

Telefon040 39 88 28 75E-Mailinfo@psg.deAnschriftPSG Projekt Service GmbH
Neuer Wall 80, 20354 Hamburg